Mesma Floresta, um Quinto do Modelo: 11/11 com 2B
Trocamos o navegador de 12B por um de 2,5B, o MiniCPM5-2B em cerca de 3,3 GB de VRAM, e rodamos o benchmark de novo na mesma floresta: 18/18, 11/11, 7/8. O placar não se moveu. O que mudou, o que não mudou e a única errada, explicada.
Todo número que publicamos até aqui saiu de um modelo de 12B. Esse era o ponto do benchmark: uma placa intermediária, um 12B quantizado e uma floresta que o fez marcar 11/11 onde o RAG top-k marcou 0/11. Esta semana fizemos a próxima pergunta óbvia. Se o ambiente está fazendo o trabalho, quão pequeno o modelo pode ficar antes de o placar se mover?
A troca
Pegamos o MiniCPM5-2B, um modelo aberto de 2,5 bilhões de parâmetros da OpenBMB, quantizado em Q8 e servido pelo Ollama, e apontamos o mesmo harness navegador para a mesma floresta: 153 nós, dois datasets SQLite, os mesmos três conjuntos de perguntas que o paper reporta. Nada na floresta mudou. A busca de entrada rodou só com BM25, sem embedder e sem índice vetorial, o que é menos ajuda de recuperação do que as linhas do 12B tiveram. Uma rodada por conjunto, em 2026-09-11.
Os placares:
- Conjunto misto, 18 perguntas: 18/18. O 12B fez 18/18.
- Estritamente multi-hop, 11 perguntas, cada uma exigindo pelo menos três saltos encadeados: 11/11. O 12B fez 11/11.
- Fork, 8 perguntas com duas a quatro sub-cadeias paralelas: 7/8. A rodada solo do paper também fez 7/8.
A precisão de citação foi 1,00 nos dois primeiros conjuntos: todo nó que o 2B citou era um que ele tinha de fato aberto, e que continha a resposta.
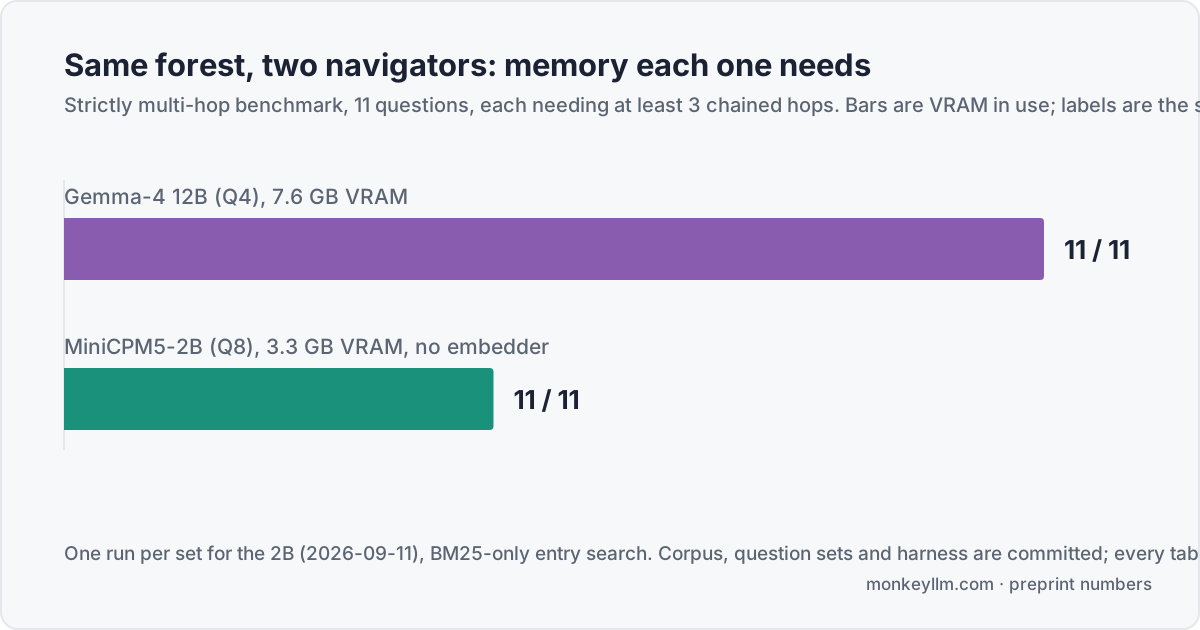
O modelo tem um quinto do tamanho e usou menos da metade da memória: cerca de 3,3 GB de VRAM contra 7,6 GB do 12B quantizado. A floresta é idêntica. O placar é idêntico.
O que custou
Modelos menores olham mais em volta. A mediana de tokens de observação por pergunta foi de 1.433 para 1.583 no conjunto estritamente multi-hop, cerca de 10% a mais, e de 867 para 1.422 no conjunto misto. Tokens por resposta correta no conjunto multi-hop ficam em 0,73x o baseline de RAG iterativo, ao lado dos 0,66x do 12B. O harness devolveu onze respostas nos dois conjuntos por prova fraca ou nó não citado, e o modelo corrigiu todas dentro do orçamento.
Não estamos publicando latência desta rodada. O modelo foi servido pela rede por uma máquina de homelab compartilhada, ocupada com outro trabalho, então o tempo de parede que vimos descreve aquela máquina, não o modelo.
A única errada
A pergunta 7 do conjunto de fork pede duas coisas de uma vez: qual região de vendas faturou mais e qual linha de produto gerou mais chamados de suporte. São dois agregados SQL sobre dois datasets diferentes. O 2B achou os dois datasets, rodou as duas consultas corretamente e respondeu corretamente no passo 5: Northeast, Wand.
Aí o harness rejeitou a resposta. A auditoria de prova quer uma frase copiada literalmente de um resultado de ferramenta, e um resultado SQL não tem frase nenhuma. O modelo voltou ao dataset de vendas, reabriu, rodou a mesma consulta de novo e ficou sem passos antes de responder outra vez. A navegação estava certa; o portão de grounding foi a falha. É uma falha diferente da errada solo do paper no mesmo conjunto, que ficou sem passos no meio da cadeia numa pergunta de largura 3, e as duas estão no relatório em vez de fora dele.
O ajuste que tivemos de fazer, e por que ele está no relatório
Na fixture pequena da Fase 0 o 2B marcou 7/10 de primeira, e as três erradas tinham a mesma forma: zero chamadas de ferramenta. O modelo raciocinava certo e depois escrevia a chamada na sintaxe de função parecida com XML em que foi treinado, em vez do JSON que o prompt pede. O harness lia isso como resposta inválida, dizia isso, e o modelo repetia a sintaxe até acabarem os passos.
O harness agora traduz essa sintaxe para a mesma ação, com cada argumento tipado pela própria tabela de assinaturas do engine. Não acrescenta ajuda nenhuma de navegação. Sem mudar mais nada, a fixture foi a 10/10 em duas rodadas seguidas. Estamos contando porque uma incompatibilidade de formato pontua exatamente como uma resposta errada, e um benchmark que esconde isso está pedindo que você confie na coisa errada.
Por que isso importa
A afirmação do paper é que grounding é uma propriedade do ambiente, não do modelo. Um 12B vencendo uma arquitetura de modelo de fronteira no mesmo corpus foi a primeira evidência. Um modelo de 2,5B igualando esse 12B na mesma floresta, com menos ajuda de recuperação, é a segunda. Gaste inteligência no ambiente para gastar menos no modelo, e o modelo de que você precisa continua encolhendo.

Também muda o que self-hosted custa. Um 12B queria uma placa de 12 GB, a que usamos no benchmark. Um 2B em 3,3 GB cabe numa placa de 4 GB, num laptop Apple Silicon ou numa máquina só com CPU, com alguma paciência. A tela de Modelos vincula qualquer endpoint compatível com OpenAI, então experimentar é uma edição de configuração: puxe o modelo no Ollama, aponte o binding de chat para ele e rode o benchmark você mesmo.
A honestidade de sempre se aplica. Uma rodada por conjunto, um benchmark gerado por nós, onze perguntas estritamente multi-hop e um preprint. O corpus, os conjuntos de perguntas, o harness e a mudança no parser estão todos versionados, e toda tabela se regenera com um comando.
Rode na sua
Puxe hf.co/openbmb/MiniCPM5-2B-GGUF:Q8_0 no Ollama, configure o endpoint de chat, construa a floresta do bench e rode o conjunto estritamente multi-hop. Os comandos exatos, e as linhas de ambiente que a Station lê, estão na documentação de deploy. Dê uma estrela ao MonkeyLLM no GitHub se o resultado mereceu, e leia o preprint em monkeyllm.com.