Mismo bosque, una quinta parte del modelo: 11/11 con 2B
Cambiamos el navegador de 12B por uno de 2,5B, MiniCPM5-2B en unos 3,3 GB de VRAM, y volvimos a correr el benchmark en el mismo bosque: 18/18, 11/11, 7/8. El puntaje no se movió. Qué cambió, qué no, y el único fallo, explicado.
Cada número que publicamos hasta ahora salió de un modelo de 12B. Ese era el punto del benchmark: una tarjeta media, un 12B cuantizado y un bosque que lo hizo anotar 11/11 donde el RAG top-k anotó 0/11. Esta semana hicimos la siguiente pregunta obvia. Si el entorno está haciendo el trabajo, ¿qué tan pequeño puede ser el modelo antes de que el puntaje se mueva?
El cambio
Tomamos MiniCPM5-2B, un modelo abierto de 2,5 mil millones de parámetros de OpenBMB, cuantizado en Q8 y servido por Ollama, y apuntamos el mismo harness navegador al mismo bosque: 153 nodos, dos datasets SQLite, los mismos tres conjuntos de preguntas que reporta el paper. Nada del bosque cambió. La búsqueda de entrada corrió solo con BM25, sin embedder y sin índice vectorial, que es menos ayuda de recuperación de la que tuvieron las filas del 12B. Una corrida por conjunto, el 2026-09-11.
Los puntajes:
- Conjunto mixto, 18 preguntas: 18/18. El 12B anotó 18/18.
- Estrictamente multisalto, 11 preguntas, cada una con al menos tres saltos encadenados: 11/11. El 12B anotó 11/11.
- Fork, 8 preguntas con dos a cuatro subcadenas paralelas: 7/8. La corrida solo del paper también anotó 7/8.
La precisión de citas fue 1,00 en los dos primeros conjuntos: cada nodo que citó el 2B era uno que realmente había abierto, y contenía la respuesta.
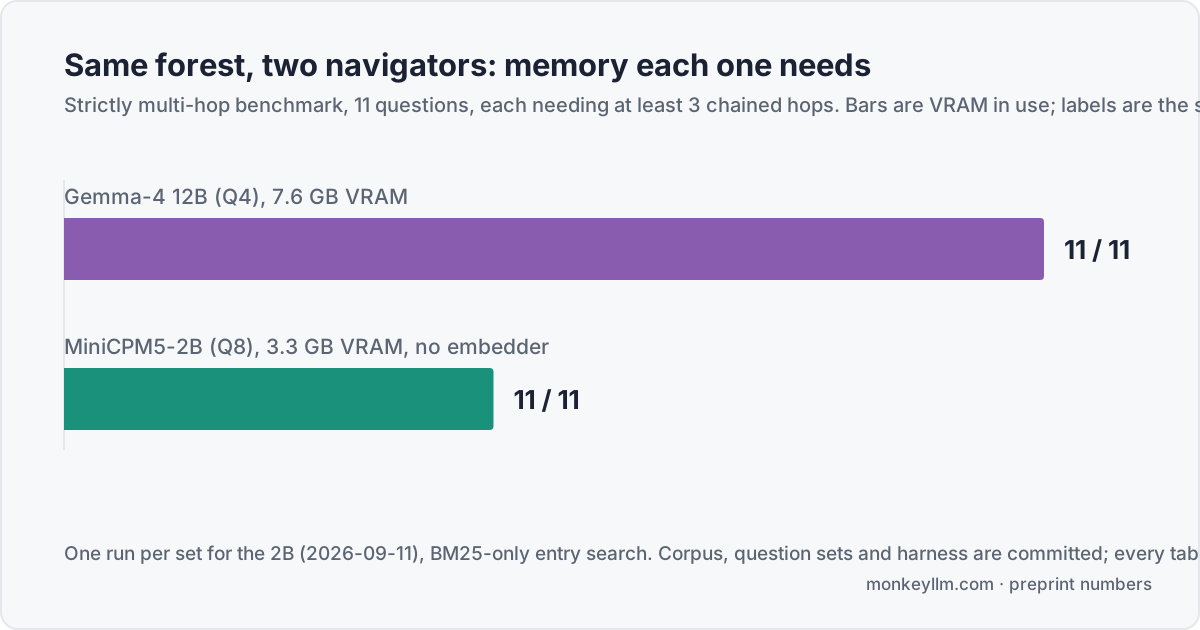
El modelo tiene una quinta parte del tamaño y usó menos de la mitad de la memoria: unos 3,3 GB de VRAM contra 7,6 GB del 12B cuantizado. El bosque es idéntico. El puntaje es idéntico.
Lo que costó
Los modelos más pequeños miran más alrededor. La mediana de tokens de observación por pregunta pasó de 1.433 a 1.583 en el conjunto estrictamente multisalto, cerca de un 10% más, y de 867 a 1.422 en el conjunto mixto. Los tokens por respuesta correcta en el conjunto multisalto quedan en 0,73x la línea base de RAG iterativo, junto a los 0,66x del 12B. El harness rebotó once respuestas en los dos conjuntos por una prueba débil o un nodo sin citar, y el modelo corrigió cada una dentro de su presupuesto.
No publicamos latencia de esta corrida. El modelo se sirvió por la red desde una máquina de homelab compartida, ocupada con otro trabajo, así que el tiempo de pared que vimos describe esa máquina, no el modelo.
El único fallo
La pregunta 7 del conjunto de fork pide dos cosas a la vez: qué región de ventas facturó más y qué línea de producto generó más tickets de soporte. Son dos agregados SQL sobre dos datasets distintos. El 2B encontró ambos datasets, corrió ambas consultas correctamente y respondió correctamente en el paso 5: Northeast, Wand.
Entonces el harness rechazó la respuesta. Su auditoría de prueba quiere una frase copiada literalmente de un resultado de herramienta, y un resultado SQL no tiene ninguna frase. El modelo volvió al dataset de ventas, lo reabrió, volvió a correr la misma consulta y se quedó sin pasos antes de responder de nuevo. La navegación estaba bien; la compuerta de grounding fue el fallo. Es un fallo distinto del fallo solo del paper en el mismo conjunto, que se quedó sin pasos a mitad de cadena en una pregunta de ancho 3, y ambos están en el informe en vez de fuera de él.
El ajuste que tuvimos que hacer, y por qué está en el informe
En la fixture pequeña de la Fase 0 el 2B anotó 7/10 al principio, y los tres fallos tenían la misma forma: cero llamadas a herramientas. El modelo razonaba bien y luego escribía la llamada en la sintaxis de función parecida a XML con la que fue entrenado, en vez del JSON que pide el prompt. El harness leía eso como respuesta inválida, lo decía, y el modelo repetía la sintaxis hasta agotar sus pasos.
El harness ahora traduce esa sintaxis a la misma acción, con cada argumento tipado por la propia tabla de firmas del motor. No agrega ninguna ayuda de navegación. Sin cambiar nada más, la fixture pasó a 10/10 en dos corridas seguidas. Lo contamos porque un desajuste de formato puntúa exactamente igual que una respuesta incorrecta, y un benchmark que lo oculta te está pidiendo que confíes en lo que no corresponde.
Por qué importa
La afirmación del paper es que el grounding es una propiedad del entorno, no del modelo. Un 12B superando a una arquitectura de modelo de frontera en el mismo corpus fue la primera evidencia. Un modelo de 2,5B igualando a ese 12B en el mismo bosque, con menos ayuda de recuperación, es la segunda. Gasta inteligencia en el entorno para gastar menos en el modelo, y el modelo que necesitas sigue encogiendo.

También cambia lo que cuesta el self-hosting. Un 12B quería una tarjeta de 12 GB, la que usamos en el benchmark. Un 2B en 3,3 GB cabe en una tarjeta de 4 GB, en un portátil Apple Silicon o en una máquina solo con CPU, con algo de paciencia. La pantalla de Modelos enlaza cualquier endpoint compatible con OpenAI, así que probarlo es una edición de configuración: descarga el modelo en Ollama, apunta el binding de chat hacia él y corre el benchmark tú mismo.
Aplica la honestidad de siempre. Una corrida por conjunto, un benchmark generado por nosotros, once preguntas estrictamente multisalto y un preprint. El corpus, los conjuntos de preguntas, el harness y el cambio en el parser están versionados, y cada tabla se regenera con un comando.
Córrelo en la tuya
Descarga hf.co/openbmb/MiniCPM5-2B-GGUF:Q8_0 en Ollama, configura el endpoint de chat, construye el bosque del bench y corre el conjunto estrictamente multisalto. Los comandos exactos, y las líneas de entorno que lee la Station, están en la documentación de deploy. Dale una estrella a MonkeyLLM en GitHub si el resultado se la ganó, y lee el preprint en monkeyllm.com.